Reakh Agent 调度系统分享
本文主要分享 Reakh Agent 调度系统
- Reakh Console(控制):把本轮对话需要的材料准备好,打包后交给执行面。
- Reakh Engine(执行):负责把任务跑完。模型在生成过程中如果提出“要调用工具”,执行面会去调用工具,把结果补回来,再继续让模型往下走。
这样同一句用户问题,可能会触发多轮“生成 + 执行”,直到问题真的处理完。
整体结构
系统里最核心的三块:
- ChatServiceImpl:在 Console 侧,做请求装配(准备上下文、知识库、工具、队友等)。
- ToolPromptBuilder:在执行侧,构建 System Prompt(把可用工具、规则、角色等组织成模型能遵守的输入)。
- StreamingResponseHandler:在执行侧,处理流式输出,解析工具调用,执行工具,必要时再触发下一轮模型调用。
Console
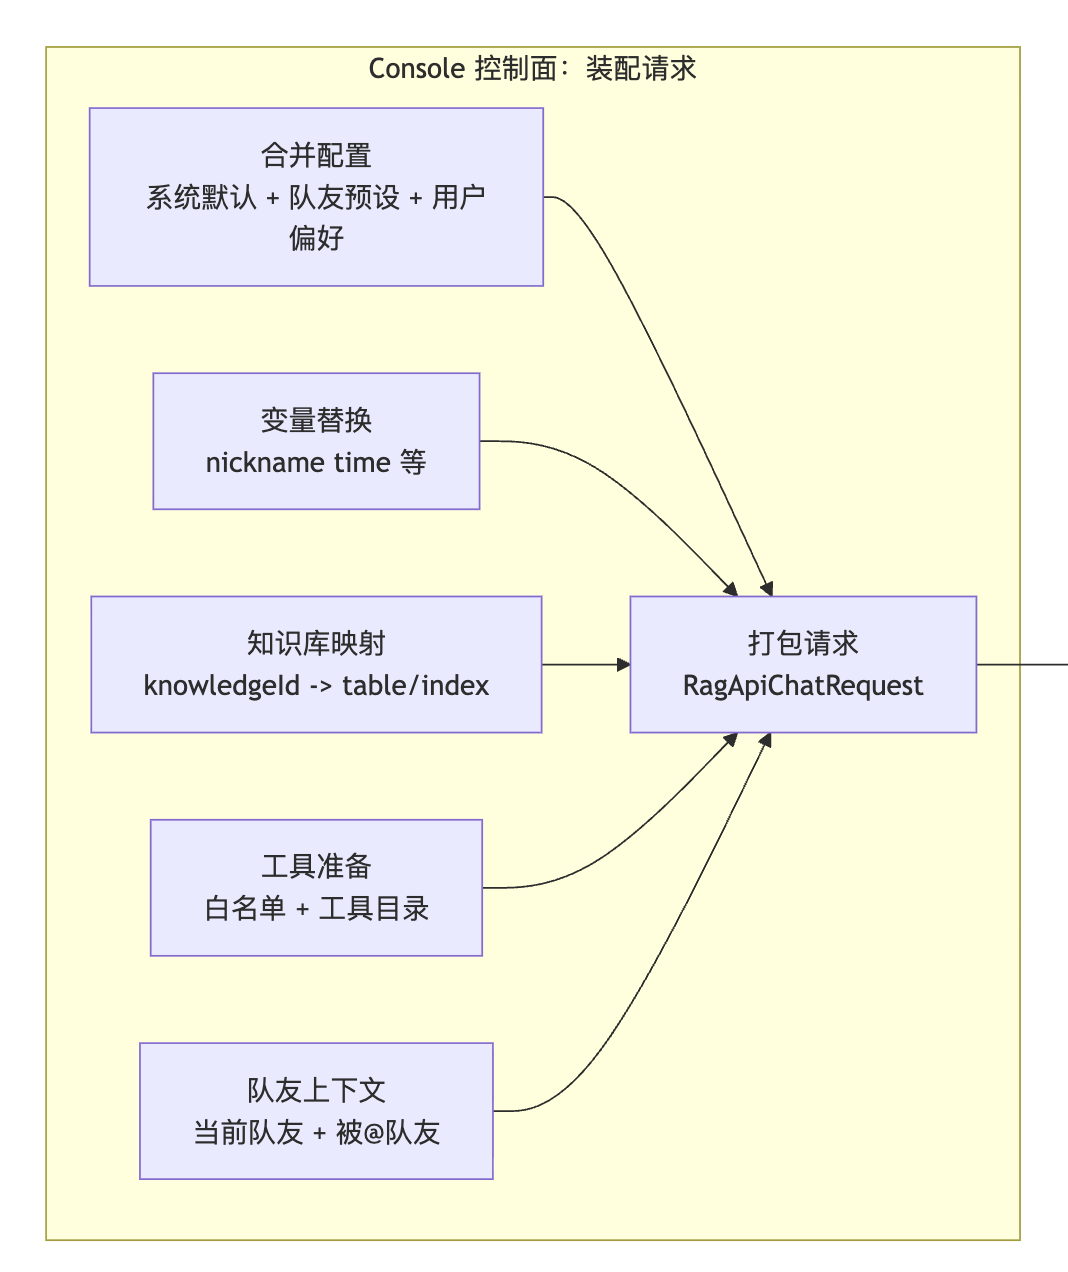
合并配置
把系统默认配置、队友预设、用户偏好合在一起。比如:
- 是否开启工具
- 是否启用知识库
- 输出语言偏好
- 该队友的角色描述和回答风格
变量替换
如果 prompt 模板里有变量,比如 {{nickname}}、{{time}},Console 这里先替换掉,执行面拿到的就是最终文本。
例子:
- 模板:你好 {{nickname}},现在时间 {{time}}
- 替换后:你好 Barry,现在时间 2026-01-29 15:xx
知识库映射
Console 会把“用户选择的数据集/知识库”转成执行面更好理解的结构(比如表/索引映射)。执行面不用再反查“这个 knowledgeId 到底对应哪个表”。
插件选择(MCP)
Console 支持选择当前对话需要的工具。
队友上下文
如果有“队友/角色”概念(比如产品专家、排障助手),Console 会把当前队友的系统设定一并带上。
如果支持 @某个队友,也会把被提及队友的上下文一起带上。
最后把这些打包成 RagApiChatRequest,发给 Sidecar(RAG Engine)。
如何执行任务
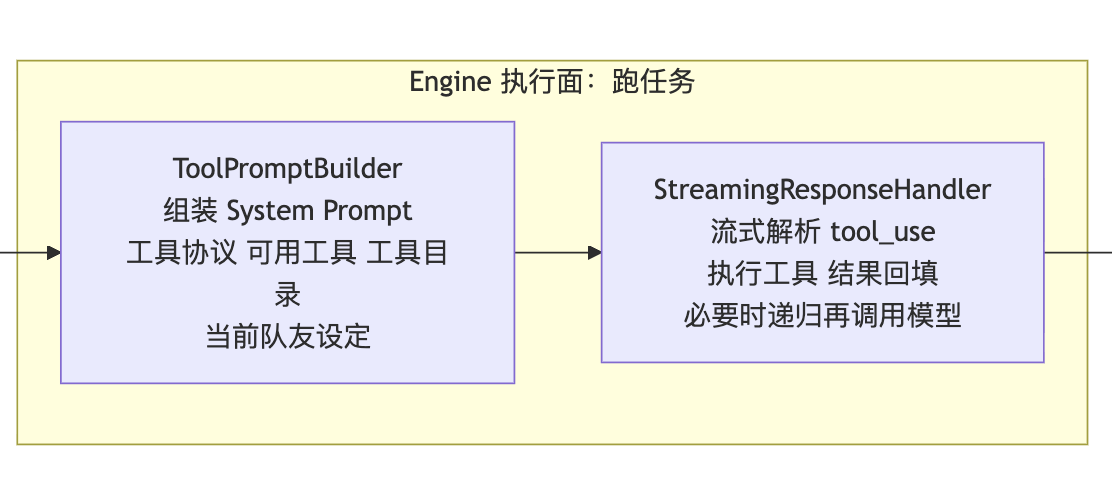
执行面的核心逻辑可以理解成三步循环:
- 模型开始生成(流式输出)
- 如果生成中出现“要调用工具”,执行工具
- 把工具结果补回上下文,再让模型继续生成
这一步最难的点在于:输出是流式的。
为什么流式麻烦?
如果模型输出的是一整段文本,解析工具调用很简单:等它输出完,全文匹配一次就行。
但流式会出现这种情况:
- 第一段输出:
<tool_
- 第二段输出:
use name="get_balance">...
- 第三段输出:
</tool_use>
也就是标签经常被切断,不能靠“全文正则”去等。
所以执行面做的是“边收边解析”,只要拼出完整的 <tool_use>,就先记录下来,具体实现可以看:TagExtractor。
Prompt 的作用
执行面要稳定,靠的不只是“能解析工具”,还得让模型“按规矩来”。这就是 ToolPromptBuilder 的职责。
ToolPromptBuilder 结构
ToolPromptBuilder 不是简单拼字符串,而是按需组装,在省 Token 的同时,让模型尽量可控。
<identity>:身份与行为要求(严谨、证据导向、避免臆测)<tool_protocol>:严格的 <tool_use> XML 协议<available_tools>:已加载工具的完整定义(含 schema)<tool_catalog>:未加载工具的摘要(用于发现)<orchestration>:编排规则(red flags、失败排错、验证规则等)<user_context>:用户持久化上下文<primary_role>:当前激活队友/角色的人设
把可用工具写清楚
模型本质是“看你给的文本”。你不告诉它工具有哪些,它就只能瞎编。
所以系统会把本轮能用的工具列表放进去,并带上参数结构,让模型能把参数填对。
工具太多怎么办
工具多会带来两个问题:
所以这里做“常用工具直接给,其他工具只给摘要”。
例子:
<available_tools>:本轮已加载的工具(可以直接调用)<tool_catalog>:未加载工具(只显示名字和一句说明)
模型如果真想用未加载的工具,需要先走一步“加载工具定义(lookup_tool_arguments)”。
例 1:查余额,不够就充值
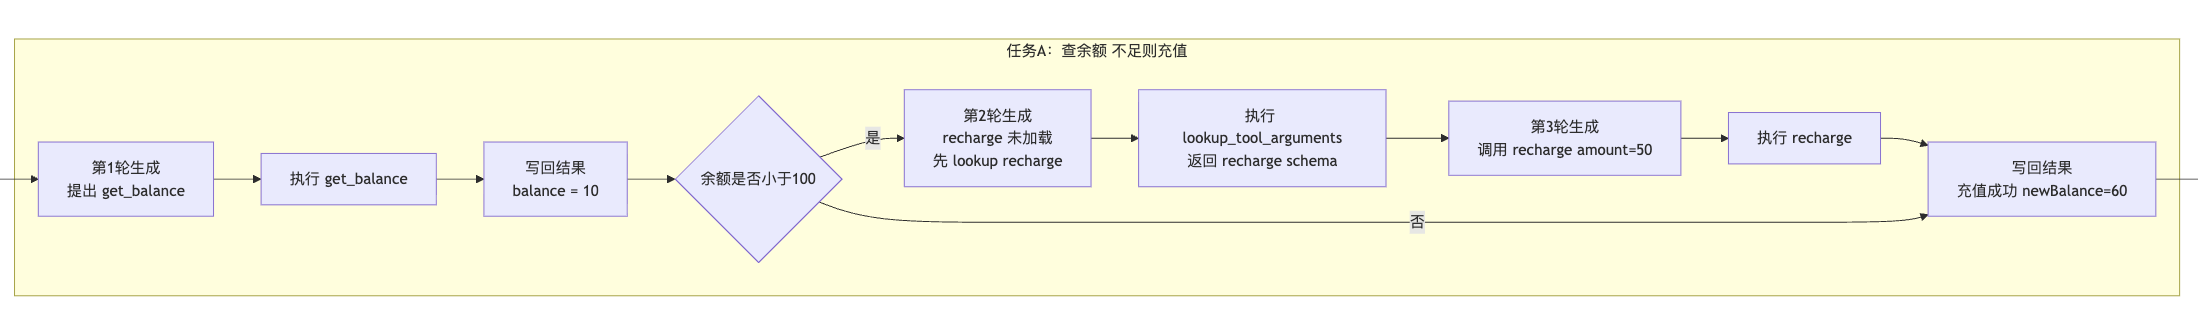
用户输入:
“帮我查皮卡的余额,如果不足 100 就充值 50”
执行过程大致是:
第一轮:模型先规划并发起工具调用
模型输出里会包含工具请求(简化描述):
执行面解析到这个工具请求后,不会把这段 XML 直接原样吐给用户,而是去执行工具。
工具执行
工具返回:
执行面把结果写回对话历史(作为“已发生事实”),类似:
<tool_use_result>余额=10</tool_use_result>
第二轮:模型看到结果后继续推理
模型读到“余额=10”,会继续生成下一步:
- 调用 recharge(user=皮卡, amount=50)
执行面执行充值工具,得到:
再把结果写回历史,然后模型继续生成最终答复:
“已查询余额 10,已充值 50,当前余额 60(或提示你再查一次余额)”
关键点在于:模型不是一次就给最终答案,而是每拿到一次真实结果,就推进一步。
例 2:查天气并发邮件
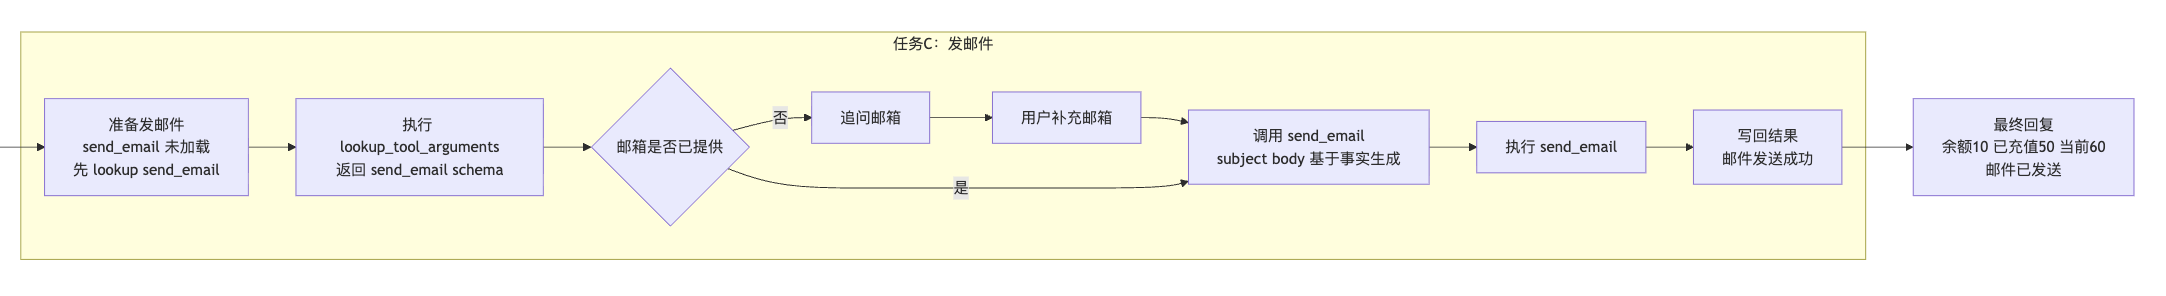
用户输入:
“我明天去北京旅游,查天气并发我邮箱”
第一轮通常会发生两件事:
- 模型先调用天气工具(因为必须先拿到天气)
- 邮箱如果没给,模型会追问(这类信息系统没法凭空猜)
流程:
- get_weather_forecast(city=北京, days=1) → 得到“晴,24°C”
- 模型生成追问:“发到哪个邮箱?”
- 用户补邮箱
- 模型调用 send_email(to=xxx, subject=..., body=...)
这里执行面需要做的是:
- 把天气结果写回去,模型才能生成邮件正文
- 工具调用链跑完后,输出给用户“已发送”
记忆系统
前面讲的是一轮任务怎么跑完。但真要把 Agent 当成“人”用,还是需要一个记忆系统。
所以 Reakh 做了一个相对克制的记忆闭环:
分层写入
会话结束后,系统不会马上把对话丢进“记忆提取”。第一步是一个 Gatekeeper,只负责判断这轮对话里哪些内容值得长期保留。它按四类记忆分别给结论:
- 身份(Identity):比较稳定的用户属性,比如职业、常用身份信息
- 偏好(Preference):长期有效的回答风格、固定要求、禁忌
- 上下文(Context):长期项目、目标、正在推进的事情,以及状态变化
- 经验(Experience):踩坑后的结论、可复用的排查套路
只有 Gatekeeper 对某一层返回“需要提取”,才会触发后续抽取。这步减少 token 消耗,也避免把大量聊天噪声塞进数据库。
通过 Gatekeeper 之后,按层走不同的规则,主要是为了结构清晰、减少误判:
- 身份层:只抓稳定信息,避免把临时状态当成“画像”
- 偏好层:重点区分“任务要求”还是“长期偏好”
- 例:“这次用英文输出”更像任务要求,通常不记
- 例:“以后别太口语化,尽量结构化”更像长期偏好,值得记
- 上下文层:跟踪项目状态(比如从 Exploring 到 Active,再到 Completed),方便后续对话少补背景
- 经验层:不记过程,记结论和套路。比如“工具调用失败先看参数缺失/权限/环境,再决定重试还是换方案”
去重记忆
写入数据库前会做一次向量相似度检索。如果发现已有记忆和新内容高度相似,就执行 UPDATE,而不是 INSERT。这样同一条偏好、同一个项目状态,会被更新成更接近现状的版本。
读取回忆
读取时参考记忆的新旧程度和使用频次,选取 Top N 后,会格式化成一个 [User Memory] 块,拼到 System Prompt 的尾部当背景信息用。
关键细节
递归要有上限
如果工具一直失败,模型可能会反复尝试。没有上限就会一直循环。
所以系统会设一个最大次数,比如最多递归 5~10 次,超过后停止继续调用,并输出一个“无法继续,需要补信息”的结果。
工具失败回填“报错信息”
工具报错时,直接把“失败”塞回去意义不大,模型不知道怎么改。
但把整段堆栈全塞回去也不合适,浪费 token,还会污染上下文。
实践里更有用的是:
- 错误类型 + 关键原因
- 哪些参数缺失/不合法
- 如果是外部服务错误,给出状态码/简短错误信息即可
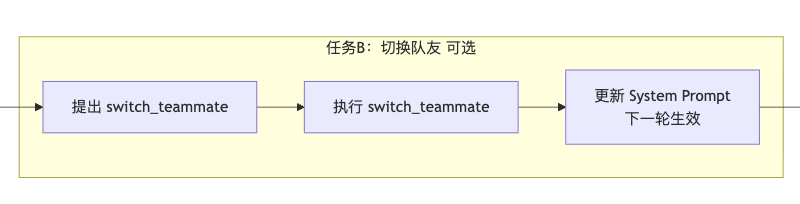
队友切换更新提示词
如果一个工具会触发“切换角色(switch_teammate)”,下一轮模型输入里必须同步更新系统设定。
否则会出现:上下文认为自己是“xx 助手”,system prompt 还是“产品介绍助手”,输出会乱。
总结
Reakh 的 Agent 调度系统主要解决的是:让 AI 能持续把一件事做完。
后续如果把 沙箱、脚本执行、受控网络/文件访问 这类工具补齐,整体就能往更强的通用 Agent 能力走,形态上会更接近 Manus 这类产品。
区别点在于:Reakh 还有 队友系统。不同队友有明确的角色边界、工具权限和上下文来源,调度时可以按场景切换到更合适的“人设 + 工具集”,通常会比单一大而全的 Agent 更准确。
技术 · #AI Agent · #工具调用 · #提示词编排
