RAG、Chat2SQL 与结构化交互实践
从早期 CloudCanal 支持了 RAG 检索任务,到最近 CloudDM 支持的 Chat2SQL 辅助查询,其实都是对如何把大模型能力融入实际业务,前者通过检索为模型提供可信的知识,后者是通过自然语言转化为 SQL,辅助用户查询数据。
在具体实现过程中,最初采用的是 Workflow,将检索,生成,校验等固定的步骤组合成工作流。但其实效果不理想,固定流程中如果中间某一步依靠的大模型出现幻觉,就会导致整个工作流产生的结果不可用;所以后续又引入了 Agent 的思想,把能力都变成工具,模型能自主执行 - 思考 - 纠错。
本文将以这两个项目为背景,介绍从 Workflow 到 Agent 的实践过程,以及其中的一些取舍,同时也会结合 Chat2SQL 讨论下 Tool 和结构化协议,将模型的执行过程与前端交互连接起来。
Workflow
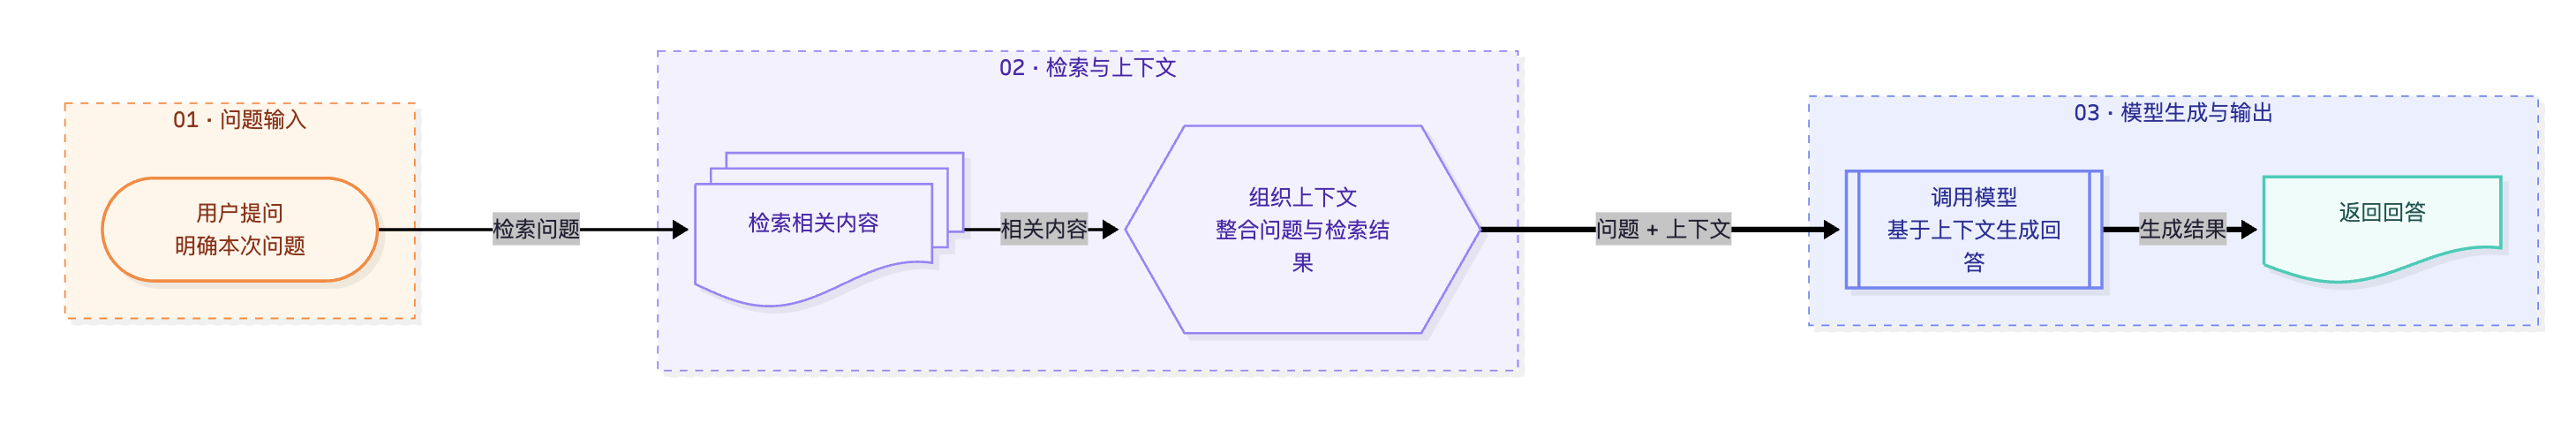
Workflow 是早期 LLM 应用组合的一种承载的方式,用户可以通过工作节点的方式来连接、组合、构建不同的业务逻辑,并结合 LLM 同时也让其参与进工作节点。
以 RAG 为例,一条基础流程可以是:
Chat2SQL 也可以采用类似的组织方式:
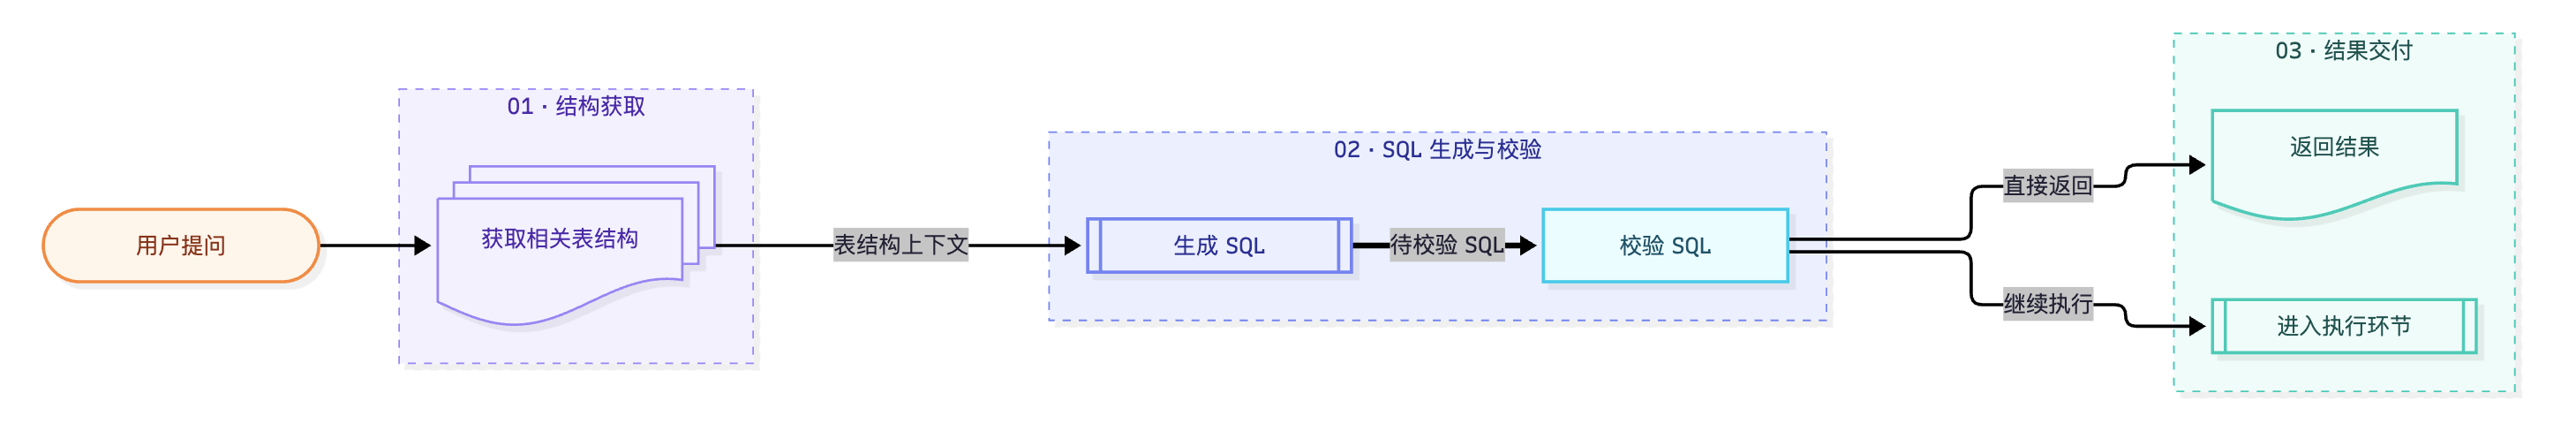
早期因为具体技术栈缺乏,要想把 LLM 引入业务,其改造量是不少的,Workflow 就巧妙的通过可视化任务的方式,帮助用户在早期构建其一个个 LLM 应用。
但在这种模式下,流程需要开发人员来预设具体的流程,当任务需要多次检索、根据错误修改 SQL,或者向用户补充确认信息时,固定流程就需要增加更多分支和状态处理。这也是我们后续探索 Agentic 设计的起点。
从 Workflow 到 Agent
面对模型的幻觉、错误,单靠 Workflow 的 Fallback 始终达不到最好的效果,模型有时候可能不是一次调用就达到用户的预期,还需要上一次调用的结果进行判断思考。为了解决这些问题后续就引入了 Agent 的 ReAct 架构,执行 - 思考 - 观察 往复循环 ,这里的核心变化是模型能够在持续过程中得到反馈,一次执行完毕后,系统会再次加入上下文,再交给模型判断:当前结果是否足够满足回答用户的问题?是否需要补充信息?如果执行失败,如何进行调整重试。
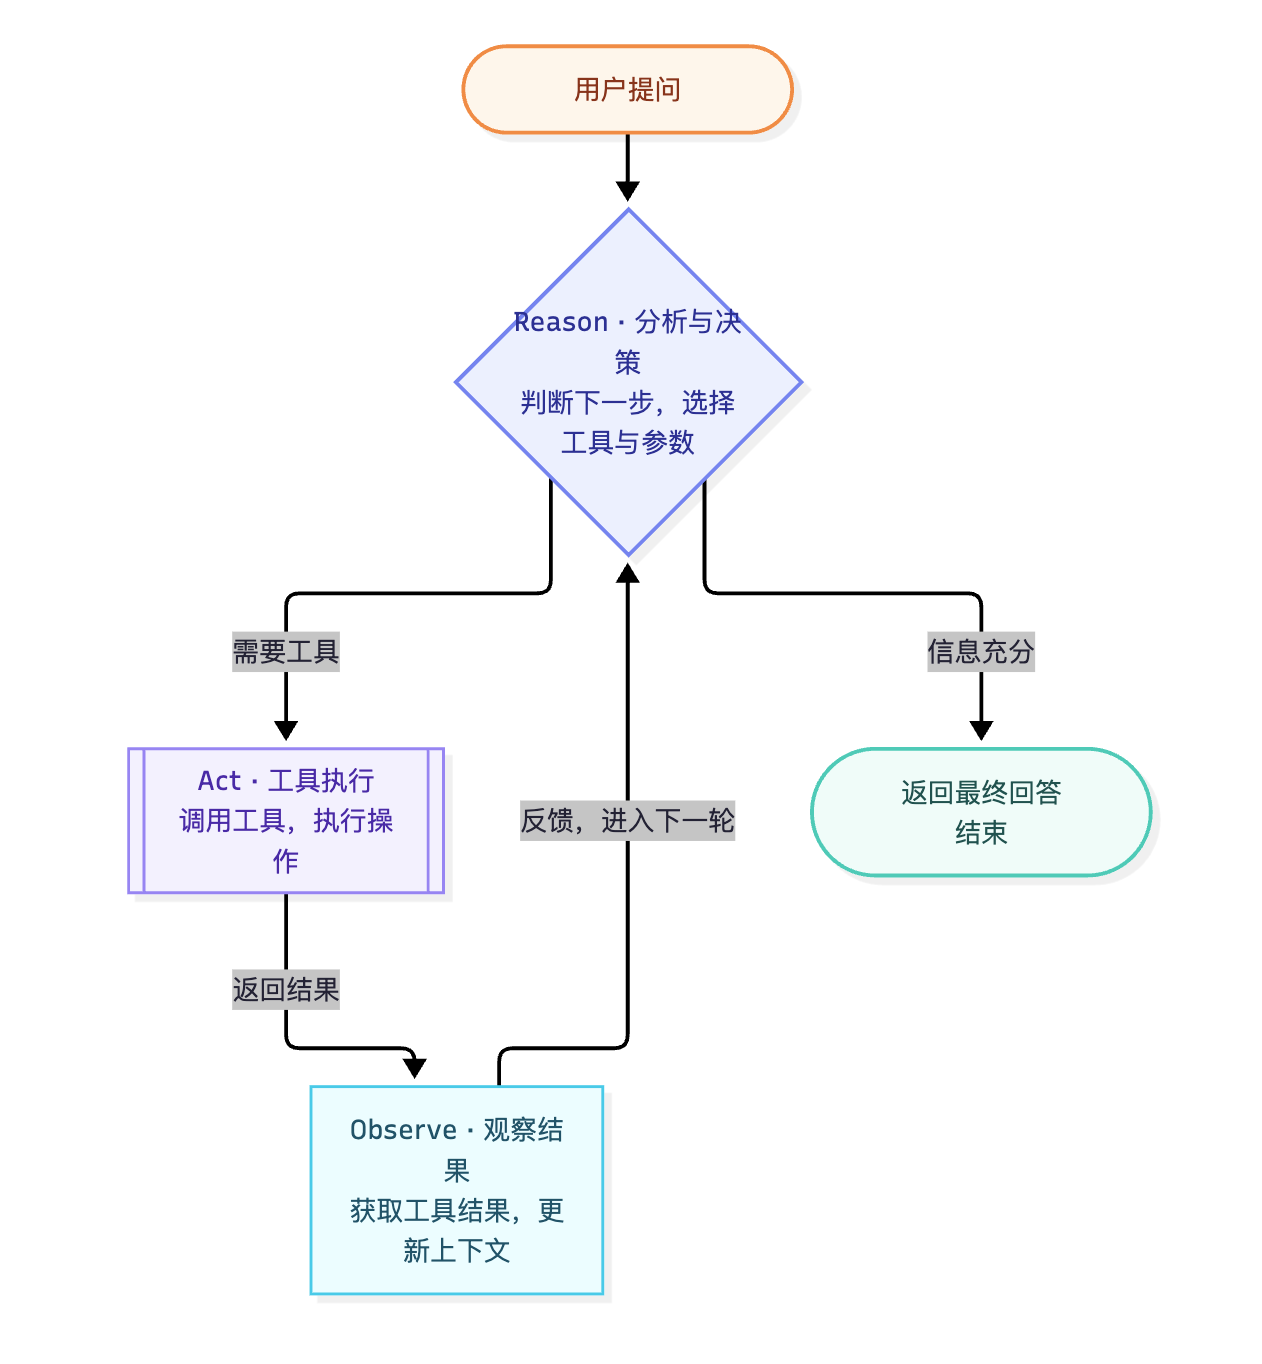
以 Chat2SQL 为例,模型第一次获取的表结构不一定足够生成 SQL,因为从语义到实际的表结构存在一定的模糊性,模型需要根据语义和表名、字段进行关联推理,有时候会因为用户提供信息不准确而出现幻觉。假设用户需要按客户所在地区统计一个月的订单信息,模型能识别到主体是订单,查询订单表后发现只有客户 ID,没有地区信息,还需要先查询客户表获得地区 ID,再关联地区表来查询。
在具体的固定流程中,如果从语义推理表这一步失败后没有获取到预设的关联表信息,模型可能会根据不完整的信息生成错误的 SQL,甚至会编造一些不存在的字段。采用 Agent 方式后,模型可以根据工具返回表的结构,判断当前信息是否足够,逐步的自我反馈,生成正确的信息。
工具设计与结构化交互
RAG 和 Chat2SQL 的工具设计需要结合具体的业务流程,明确哪些操作可以让 LLM 来执行,以及考虑与用户直接的交互。
RAG 涉及的主要是检索已有的内容,SQL 比较固定且不涉及业务的修改,因此调用安全性上比较安全,只需要利用返回信息决定是否继续检索或直接回答。
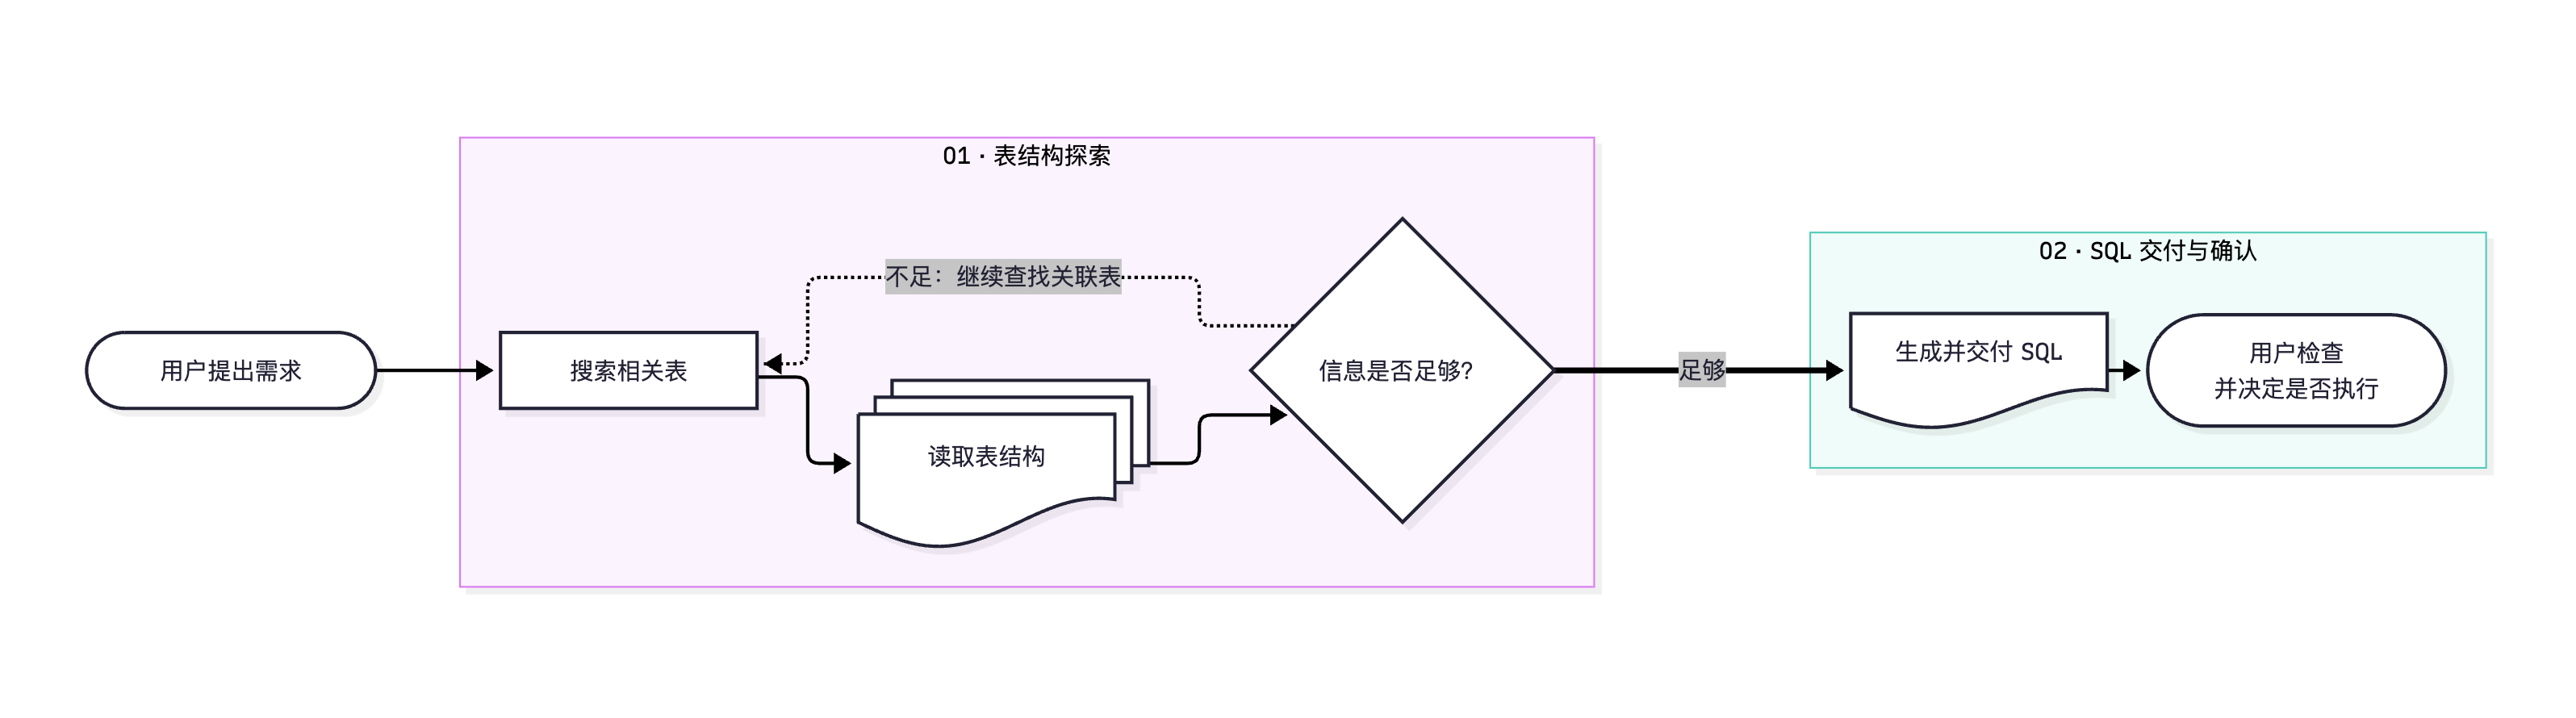
而 DM 的 Chat2SQL 则不太一样,模型可以通过工具查看表结构,查找关联表,逐步获取对应 SQL 所需的上下文,但最终只生成 SQL,由用户来执行。这个手段相对来说比较安全,且比较符合 DM 作为业务查询工具,保持了权限等逻辑的统一。
具体来说,DM 通过 listTables 搜索用户有权访问的表和视图,返回对应的 objectRef ;模型再使用 describeTables 读取字段、注释和已知主外键信息。如果发现信息不足,可以继续搜索和读取其他表,逐步确认关联关系,最后调用 generateSql 交付 SQL。
这也带来了一个问题,生成的 SQL 如何呈现,如果只通过纯文本返回给前端,前端很难区分 SQL 和解释文字。如果用 Prompt 来固定具体的结构呢?例如定义一个 JSON 或者 XML 协议:
<sql>
  select * from xxx;
</sql>
但是实践下来,如果对话长了后会导致 System Prompt 权重降低,模型可能不会在末尾输入一个类似的协议文本,如果要达到比较好的效果可能要对模型进行微调,但这样就缺失了通用性。但其实协议化的交互其实可以直接利用模型的 Function Call 能力,这个是模型已经训练好的通用的结构化能力。
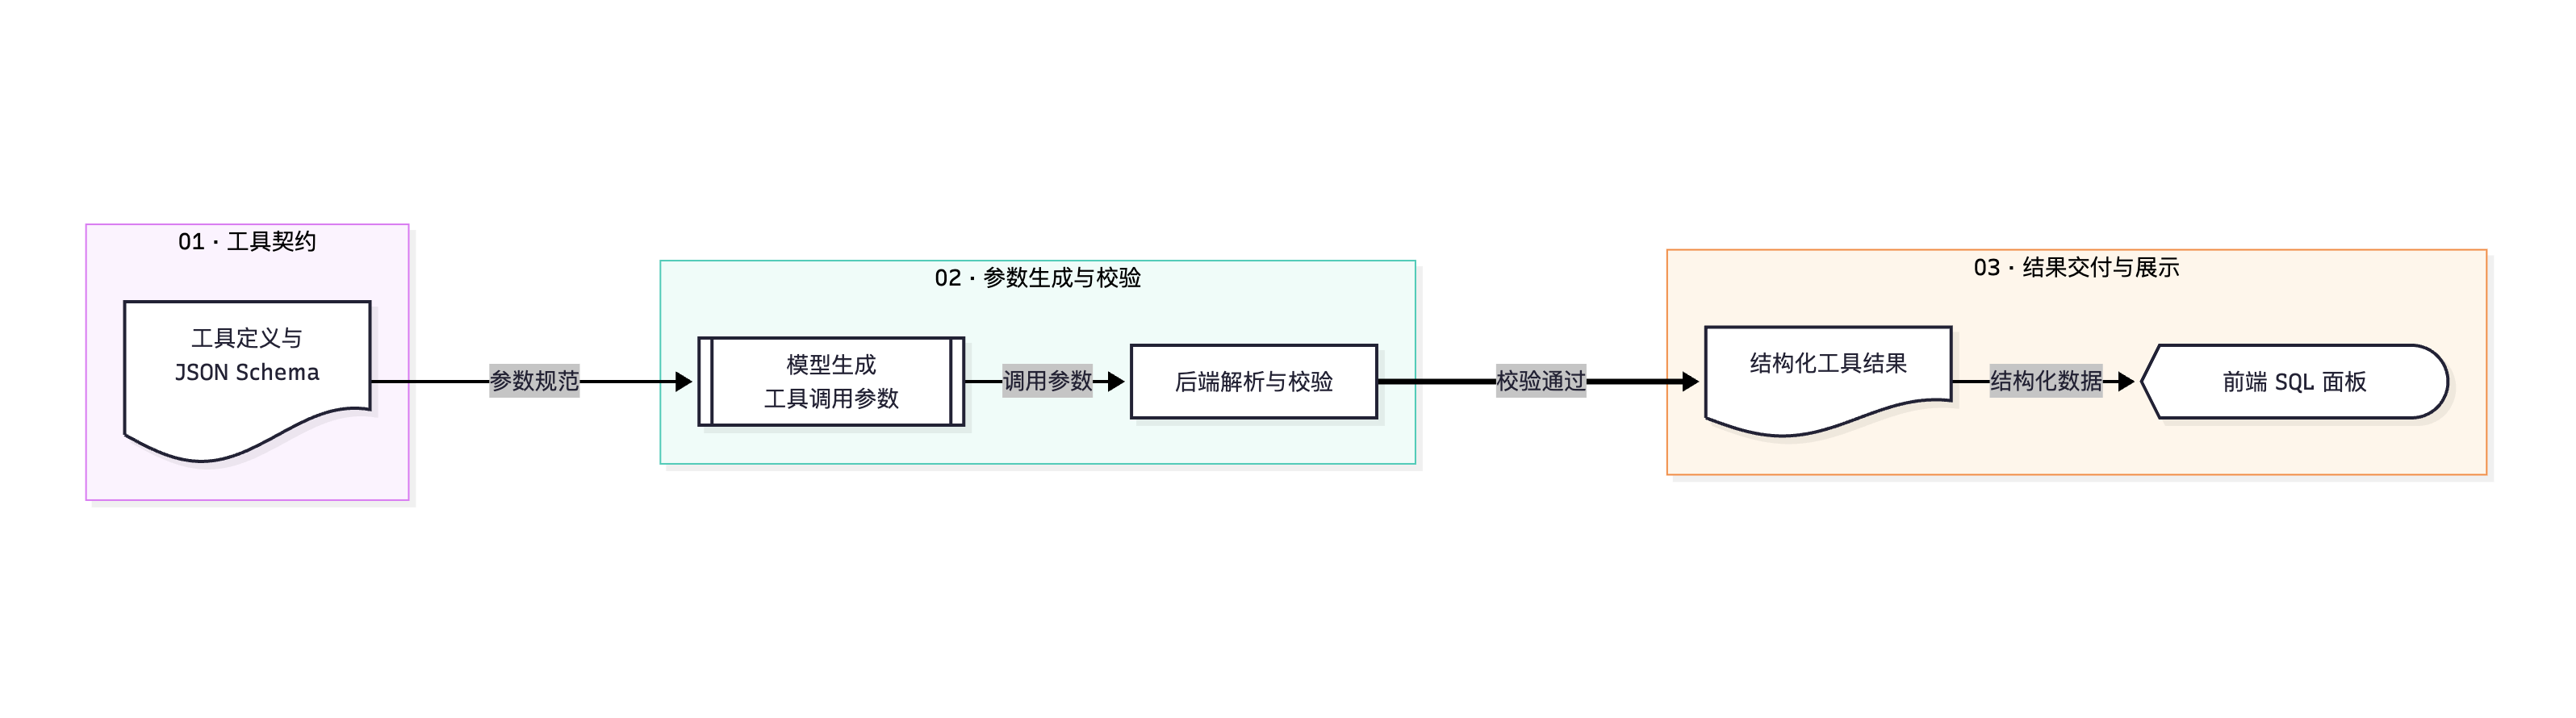
为了理解这个过程,可以先看它的参数定义。根据实际工具定义,将说明文字简化后,对应的 JSON Schema 如下:
{
  "type": "object",
  "properties": {
    "sql": {
      "type": "string",
      "description": "完整的 SQL 语句,不包含 Markdown 代码围栏"
    }
  },
  "required": ["sql"]
}
JSON Schema 描述的是数据应该具有什么结构:这里要求参数是一个对象,必须包含 sql 字段,并且字段值是字符串。模型调用工具时,则按照这个结构提交具体内容:
{
  "sql": "SELECT customer_id, SUM(amount) AS total_amount FROM orders GROUP BY customer_id;"
}
后端解析和校验参数后,将 SQL 作为结构化结果,通过工具完成事件传给前端。前端便可以明确区分 SQL 与普通回答:SQL 使用独立的代码面板展示,提供复制、插入编辑器等操作;解释文字则按照普通消息渲染。
同样的方式也可以用于用户交互。当模型无法确定业务口径时,可以调用 ask_user_questions,将问题及选项交给前端渲染。例如:
{
  "title": "确认统计口径",
  "questions": [
    {
      "id": "order_scope",
      "question": "订单金额需要统计哪些订单?",
      "type": "SINGLE_CHOICE",
      "options": [
        {
          "id": "paid",
          "label": "已支付订单"
        },
        {
          "id": "all",
          "label": "全部订单"
        }
      ]
    }
  ]
}
前端根据这些字段展示问题卡片,模型暂停处理并等待用户回答。用户提交后,系统再将反馈带入后续处理。
在 DM 中, generateSql 与 ask_user_questions 是两个独立工具,但采用了相同的设计思路:通过结构化工具调用,将模型生成的内容接入明确的产品交互。 前者交付 SQL,后者收集用户输入。Tool 因此既可以为模型提供业务信息,也可以成为模型与前端界面之间的连接方式。
总结
从 CC 的 RAG 到 DM 的 Chat2SQL,实践下来,固定的 Workflow 能比较快地把流程搭起来,但遇到信息不完整、需要多次查找的情况,预设分支就会越来越多。引入 Agent 后,可以让模型通过工具获取实际信息,根据返回结果补充上下文、调整下一步操作,减少对固定流程的依赖。
工具也不只是给模型提供信息。像 DM 中的 SQL 交付和用户提问,都可以利用 Function Call 的结构化能力,把内容交给前端渲染,让模型接入具体的产品交互。至于哪些操作可以自主完成,哪些需要用户参与,还是要结合业务来决定。
技术 · #RAG · #Chat2SQL · #AI Agent · #JSON Schema
